

I. 서 론
II. 관련 연구
2.1 한국어 음성인식과 평가용 코퍼스
2.2 대규모 언어모델 디코더를 결합한 음성인식
2.3 생성형 디코딩의 추론 하이퍼파라미터
III. 평가 대상 모델 및 데이터
3.1 Qwen3-ASR & Whisper
3.2 평가 데이터
IV. 평가 지표 및 실험 방법
4.1 평가 데이터 정규화
4.2 실험 설정
4.3 평가 지표
V. 결과 및 고찰
5.1 Qwen3-ASR의 다중 코퍼스 성능
5.2 추론 파라미터의 영향
5.3 권장 추론 설정 도출 및 검증
5.4 Whisper 대비 비교
VI. 결 론
I. 서 론
자동 음성인식(Automatic Speech Recognition, ASR)은 음성 신호를 입력으로 받아 문자 또는 단어 단위의 전사를 생성하는 기술로 음성 정보의 텍스트화와 음성 기반 상호작용에 활용된다. 최근에는 대규모 다국어 음성 및 텍스트 데이터로 학습된 모델이 등장하면서 언어별 모델을 별도로 구축하지 않고 여러 언어의 전사를 처리할 수 있게 되었다. 또한 음성 인코더의 출력 표현을 대규모 언어모델(Large Language Model, LLM) 디코더와 결합하는 구조가 제안되면서 자동 음성인식 분야는 음향 표현 추출과 언어모델 기반 전사 생성을 함께 다루는 방향으로 발전하고 있다.[1,2] 다만 이 구조에서는 대규모 언어모델의 디코더가 전사 토큰을 순차적으로 생성하는 만큼, 추론 시의 디코딩 설정이 출력 전사에 영향을 줄 수 있다. 이러한 구조를 따르는 모델로 최근 공개된 Qwen3-ASR은 추가 미세조정 없이 다국어 전사를 지원하며, 그중에는 본 연구가 대상으로 삼는 한국어도 포함된다. 또한 가중치가 공개되어 추론 파라미터를 직접 지정하며 반복 평가할 수 있다.[1]
그러나 한국어 지원이 곧 실제 음성 자료에서의 인식 성능을 보장하지는 않는다. 한국어는 띄어쓰기와 발음형·철자형 표기의 차이가 커서 동일한 전사라도 지표 값이 달라질 수 있다.[3] 또한 발화 양식·녹음 환경·도메인·화자 특성에 따라 코퍼스마다 인식 난이도가 다르다. 따라서 하나의 코퍼스가 아니라 특성이 다른 여러 한국어 코퍼스에 걸친 평가가 필요하지만, 대규모 언어모델 기반 자동 음성인식 모델에 대해서는 이러한 평가가 아직 충분하지 않다.
본 연구는 이러한 조건을 포괄하는 10종의 평가셋에서 Qwen3-ASR(0.6B, 1.7B)의 한국어 인식 성능을 측정한다. 이어 언어 설정, 최대 생성 길이, temperature, repetition penalty가 인식 성능에 미치는 영향을 발화 조건, 평가셋 난이도, 모델 크기, 파라미터 간 상대적 영향력의 측면에서 분석한다. 이를 바탕으로 별도의 파라미터 탐색이 어려운 환경에서 활용할 수 있는 권장 추론 설정을 도출하고 전체 평가셋에서 검증한다.
II. 관련 연구
2.1 한국어 음성인식과 평가용 코퍼스
한국어는 대규모 공개 코퍼스가 등장하기 전까지 영어·중국어 등에 비해 활용 가능한 음성 자원이 제한적이었다. 초기의 대표적 공개 자원으로 낭독체 뉴스 음성을 제공하는 Zeroth 프로젝트의 한국어 코퍼스[4]와 콜센터 목적 지향 대화 음성 ClovaCall[5] 등이 사용되었지만 규모가 작거나 도메인이 한정적이라는 한계가 있었다. 이후 AI-Hub[6]를 통해 약 969 h 규모의 대규모 자유발화 코퍼스 Korean Spontaneous Speech(KsponSpeech)가 공개되어, 정서법·발음열 이중 전사를 제공하며 한국어 음성인식 평가의 표준 벤치마크로 활용되고 있다.[3] AI-Hub에는 이 외에도 서로 다른 녹음 환경과 발화 양식을 포괄하는 회의, 고객 상담, 대학 강의, 외국인 발화 등 다양한 도메인의 한국어 음성 데이터가 공개되어 있다.
2.2 대규모 언어모델 디코더를 결합한 음성인식
기존 자동 음성인식에서 언어모델은 음향모델이 생성한 전사 후보를 별도의 디코딩 과정에서 보정·선택하는 데 쓰였다. 최근에는 음성 인코더의 출력 표현을 대규모 언어모델 디코더의 입력으로 사용하여 해당 모델이 전사 토큰을 순차적으로 예측하는 구조가 연구되고 있다. 이때 음향 표현 추출 모듈로는 대규모 약지도 학습으로 다국어 음성인식·번역을 수행하는 Whisper[2]의 인코더가 널리 쓰인다. Speech Audio Language Music Open Neural Network(SALMONN)은 Whisper 음성 인코더와 비음성 오디오 인코더를 Q-Former와 저랭크 적응(Low-Rank Adaptation, LoRA)를 통해 대규모 언어모델 디코더에 연결하였고,[7]Qwen-Audio[8]와 Qwen2-Audio[9]도 Whisper에서 초기화한 음성 인코더에 결합해 음성·소리·음악을 포괄하는 오디오 및 언어 모델로 확장하였다. 이 기법들이 개방형 오디오 이해를 지향하는 것과 달리, 음성인식에 특화된 연구도 이어져 Seed-ASR은 문맥 정보를 활용하도록 설계되었고,[10] 디코더 전용 구조로 음성을 텍스트로 변환하는 과정과 언어모델을 통합한 접근도 제안되었다.[11] 이러한 흐름의 연장선에서 Qwen3-ASR이 공개되었다.[1] 그러나 이러한 구조를 한국어 다중 코퍼스에서 검토한 연구는 아직 제한적이며, 공개 데이터셋 평가도 중국어 코퍼스를 대상으로 보고된 정도이다.[12]
2.3 생성형 디코딩의 추론 하이퍼파라미터
대규모 언어모델 디코더가 전사 토큰을 순차적으로 생성하는 구조에서는 학습된 가중치뿐 아니라 추론 시의 디코딩 설정도 출력에 영향을 준다. 토큰을 선택하는 방식으로는 여러 후보를 유지하며 확장하는 최대우도 기반의 빔 탐색과 확률 상위 k개에서 표집하는 top-k, 누적 확률이 p에 이르는 토큰 집합에서 표집하는 top-p 샘플링 등이 있으며, 생성된 토큰의 점수를 낮춰 반복을 억제하는 repetition_ penalty도 함께 쓰인다.[13,14]
III. 평가 대상 모델 및 데이터
3.1 Qwen3-ASR & Whisper
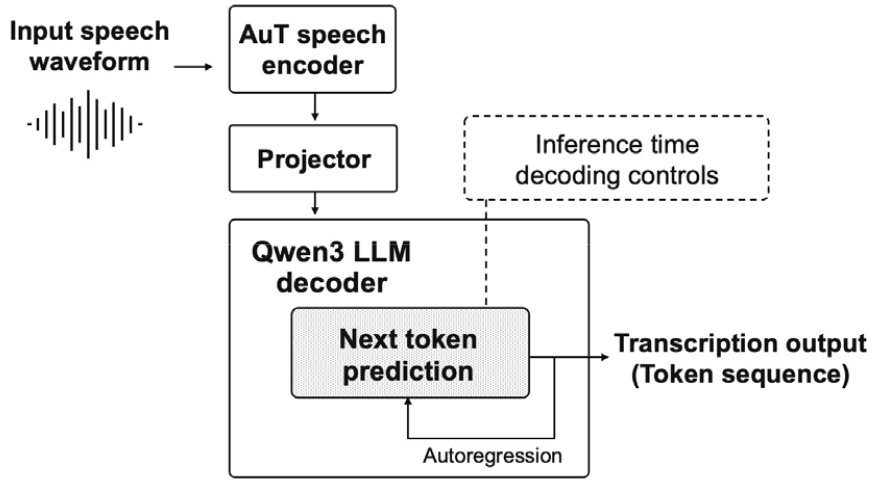
다국어 음성인식 모델 Qwen3-ASR[1]은 대규모 의사 라벨이 부여된 음성 데이터로 사전학습되었다. Fig. 1과 같이, 입력 음성은 128 차원의 필터 뱅크 특징으로 추출된 후 약 8분의 1 수준의 시간축 길이로 다운샘플링되어[1] Audio Transformer(AuT) 음성 인코더에 입력되고, 인코더는 이를 연속적인 음향 임베딩 시퀀스로 변환한다.[1] 이 표현은 두 개의 선형층과 가우시안 오차 선형 유닛 활성화 함수로 구성된 프로젝터를 통해 Qwen3 언어모델의 입력 공간으로 사상된 뒤, Qwen3-Omni 계열 디코더가 이전 토큰과 음향 표현을 조건으로 다음 전사 토큰을 순차적으로 예측하여 최종 전사를 산출한다. 공식 모델 설정에서 AuT 음성 인코더 층수는 각각 18개와 24개이고, 음향 표현의 차원은 각 896과 1024, 프로젝터가 사상하는 언어모델의 입력차원은 각각 1024와 2048이다.[15] 공개된 모델은 0.6B와 1.7B 두 규모이며, 0.6B는 경량 모델로 제시되었다.[1]
본 논문에서는 0.6B와 1.7B를 모두 평가 대상으로 삼아 모델 크기에 따른 인식 성능과 추론 설정의 영향의 차이를 함께 살핀다. 비교를 위한 공개 베이스라인으로는 Whisper[2]를 규모가 가장 가까운 쌍으로 사용하여, 1.7B는 약 15억 파라미터의 Whisper large-v3와 0.6B는 약 7.7억 파라미터의 Whisper medium과 비교한다.
본 연구가 다루는 language, max_new_tokens, temperature, repetition_penalty는 Fig. 1의 점선 영역과 같이 언어모델 입력과 디코더의 토큰 생성 단계에 작용하여, 음성의 음향 표현으로부터 어떤 전사를 만들지를 바꾼다.
language는 인식 언어의 지정 여부를 입력 프롬프트로 전달하고, max_new_tokens는 생성 토큰 수의 상한으로 종료 토큰이 먼저 나오지 않으면 상한에서 생성을 중단시킨다. 두 설정은 어떤 토큰을 고를지에는 관여하지 않으므로, 상한이 발화 길이보다 넉넉하면 값을 늘려도 전사는 달라지지 않는다.
반면 temperature와 repetition_penalty는 디코더가 매 단계에서 어떤 토큰을 고를지를 바꾼다. 디코더는 각 단계에서 어휘 전체에 점수를 매기고 이를 확률로 바꾸어 다음 토큰을 정하는데, temperature는 이 확률의 분포를 좌우한다. 값이 커지면 확률이 아래로 퍼져 점수가 낮은 토큰도 선택될 수 있고, 값이 작으면 점수가 가장 높은 토큰에 확률이 몰린다. 0에서는 표집 자체를 하지 않아 실행을 반복해도 같은 전사가 나온다. repetition_penalty는 확률로 바꾸기 전에 이미 생성된 토큰의 점수를 낮춰 같은 토큰이 다시 선택될 가능성을 줄인다. 1.0은 점수를 그대로 두는 값이어서 억제가 적용되지 않고, 1.0보다 클수록 억제가 강해진다. 한국어는 조사·어미와 같은 기능 형태소가 반복적으로 나타나므로, 이 억제가 실제 발화의 반복에도 적용되면 전사 정확도에 영향을 줄 수 있다.
3.2 평가 데이터
9개 한국어 음성 코퍼스로부터 10개 평가셋을 구성하였다. 동일 코퍼스라도 공식 분할이나 전사 방식이 다른 경우 별도 평가셋으로 구분하고, 성능도 평가셋 단위로 산출하였다. 특히, KsponSpeech는 공식 분할에 따라 eval_clean과 eval_other로 나누었다.
KsponSpeech는 약 2,000명의 화자가 참여한 자유발화 코퍼스로 정서법 및 발음열 이중 전사를 제공하며,[3] Zeroth-Korean은 뉴스 중심의 낭독 음성으로 구성된다.[4] AI-Hub 기반 평가셋은 회의, 고객 응대, 강의, 외국인 발화, 숫자 발화, 저음질 전화망, 복지·민원 상담 등의 도메인을 포괄한다. 발화 단위 세그먼트는 그대로 사용하고, 샘플링 레이트는 16 kHz로 통일하였다. 각 평가셋의 특성은 Table 1과 같다.
Table 1.
Evaluation sets and transcript preprocessing.
추론 설정 탐색에는 연산 비용을 고려하여 평가셋별 표본을 사용하였다. 표본 규모는 KsponSpeech와 유사한 약 3,000개 발화로 설정하였다. 규모가 큰 평가셋은 발화 단위로 무작위 추출하였으며, 전체 발화 수가 이를 넘지 않는 KsponSpeech와 Zeroth-Korean은 전체 발화를 표본 및 최종 평가에 사용하였다.
IV. 평가 지표 및 실험 방법
4.1 평가 데이터 정규화
한국어 음성 코퍼스에는 발음형·철자형 전사, 이중 전사, 간투·잡음 표지, 숫자·특수기호, 띄어쓰기 차이 등이 포함되므로, 이러한 표기 차이가 실제 인식 오류로 잘못 계산되어 평가 결과를 왜곡하지 않도록 정규화를 수행한다.[16,17]
참조 전사와 모델 출력에 평가셋별 동일한 정규화 함수를 적용하여 표기 차이를 제거하고 실제 인식 오류만 반영하였다. KsponSpeech 계열은 공개 전처리 기준에 따라 이중 전사와 특수 표지를 처리했으며, 그 외 평가셋은 라벨 형식에 맞춰 문장부호, 간투·잡음 표지, 숫자 표기, 영문 대소문자 등을 정규화하였다. 세부 규칙은 Table 1에 제시하였다.
4.2 실험 설정
Qwen3-ASR의 추론 조건이 한국어 인식 성능에 미치는 영향을 분석하기 위해 language, max_new_tokens, temperature, repetition_penalty 네 항목을 대상으로 하였다. 각 파라미터의 탐색값은 Table 2와 같으며, 네 항목을 완전 교차하여 평가셋별·모델별로 72개(2 × 3 × 4 × 3)의 추론 설정을 구성하였다. 동일한 범위를 0.6B와 1.7B에 모두 적용하여 모델 크기에 따른 차이를 함께 분석하였다. temperature가 0보다 큰 조건에서는 확률적 표집으로 실행 간 출력이 달라질 수 있어, 각 조합을 한 차례 실행한 결과를 분석에 사용하였다.
Table 2.
Search space for Qwen3-ASR inference parameters.
| Parameter | Candidate values | Number of values |
| language | korean, auto | 2 |
| max_new_tokens | 512, 1024, 2048 | 3 |
| temperature | 0.0, 0.1, 0.2, 0.3 | 4 |
| repetition_penalty | 1.0, 1.1, 1.2 | 3 |
모델 가중치는 Hugging Face에 공개된 체크포인트[15]를 그대로 사용하였고, 추가 학습이나 파라미터 업데이트는 적용하지 않았다. 추론은 Qwen3-ASR의 경우 vLLM으로, Whisper의 경우 Hugging Face Transformers로 수행하였고, 정밀도는 각각 bfloat16과 float16을 사용하였다. 실험은 NVIDIA A40 GPU 8장으로 구성된 서버에서 수행하였으며, Qwen3-ASR은 32개 발화를 묶는 미니배치 추론으로, Whisper는 미니배치가 지원되지 않아 발화를 순차적으로 처리하였다.
4.3 평가 지표
한국어는 음절 단위로 실현되어 문자 단위 평가가 적합하므로, 본 연구는 문자 오류율(Character Error Rate, CER)을 기본 지표로 사용한다. CER은 참조 전사와 모델 출력 사이의 대체·삭제·삽입 오류 수를 전체 문자 수로 나눈 값이다. 다만 한국어는 띄어쓰기 기준이 전사 규약에 따라 달라지기 때문에, 공백을 제거한 뒤 산출한 문자 오류율을 공백 제거 문자 오류율(CERNS)로 표기하고 이를 최종 지표로 삼았다.
한편 여러 평가 셋은 발화 양식, 음질, 녹음 환경, 화자 특성이 서로 달라 동일한 추론 조건에서도 기준 성능이 다르게 나타난다. 이 때문에 여러 평가셋에 공통으로 적용할 하나의 설정을 정하려면, 그 설정이 각 평가셋의 개별 최적 설정에 비해 얼마나 뒤처지는지를 평가셋 간 비교가 가능한 형태로 재야 한다. 이를 위해 각 평가셋의 최저 오류율 대비 초과분인 성능 손실을 사용하였다.
평가셋 에서 추론 설정 𝜃로 산출한 공백 제거 문자 오류율을 CERNS로 두면, 성능 손실 는 해당 평가셋에서 관측된 최저 오류율 대비 그 설정의 초과분으로 Eq. (1)과 같이 정의된다.
여기서 𝛳´는 비교 대상이 되는 전체 탐색 조합의 집합이고, min항은 평가셋 에서 그 조합 전체에 걸쳐 관측된 최저 CERNS를 의미한다. 따라서, 는 항상 0 이상이며, 0이면 해당 조건이 해당 평가셋의 최저값을 기록한 경우다.
여러 평가셋에 걸쳐 안정적인 설정을 찾기 위해, Eq. (2)와 같이 성능 손실을 평가셋 전체에 대해 평균한 평균 성능 손실 를 권장 설정 선정 기준으로 사용하였다.
여기서 는 평균 계산에 포함된 평가셋의 수이며, 가 작을수록 여러 자료에서 최저 오류율에 가까운 설정이다.
V. 결과 및 고찰
5.1 Qwen3-ASR의 다중 코퍼스 성능
Table 3은 평가셋별 최적 추론 설정과 그때의 CERNS를 정리한 것이다. 값에 따른 차이가 거의 없던 language와 max_new_tokens는 표에서 제외하였으며, max_new_tokens는 Foreigner(1.7B)와 LowQCall(0.6B)에서만 512가 최저였다.
Table 3.
Minimum CERNS for each evaluation set in the grid search on the sample, with the corresponding temperature and repetition penalty. Multiple values denote ties at the observed minimum.
데이터셋에 따라 최저 CERNS는 Welfare의 2.22 %(1.7B)에서 LowQCall의 16.48 %(1.7B)까지 넓은 범위를 보이며, 이는 도메인과 음질 조건에 따른 인식 난이도의 차이를 반영한다. 또한, 평가한 모든 데이터셋에서 1.7B가 0.6B보다 낮은 CERNS를 기록하여 규모가 큰 모델이 한국어 전사에서 더 안정적인 성능을 보임을 확인할 수 있다.
5.2 추론 파라미터의 영향
Fig. 2는 평가셋별 최저 대비 성능 손실 Eq. (1)을 temperature와 repetition_penalty 조합별로 평가셋 전체에 대해 평균한 결과, 즉 Eq. (2)의 평균 성능 손실 이다(language = korean, max_new_tokens = 512 고정). 두 모델 모두 language = korean, repetition_penalty = 1.0 조건에서 대체로 최저값 또는 이에 근접한 값을 기록하였다. 언어 설정은 Fig. 2의 축에는 포함되지 않으나, 전체 탐색에서 대부분의 평가셋은 language = korean에서 최저 오류율을 보였다. 예외적으로 Zeroth-Korean에서는 언어 설정 간 차이가 거의 나타나지 않았고, NumPattern에서는 1.7B의 경우 repetition_penalty = 1.1에서, 0.6B의 경우 언어 설정 auto에서 최저 오류율이 관측되었다.
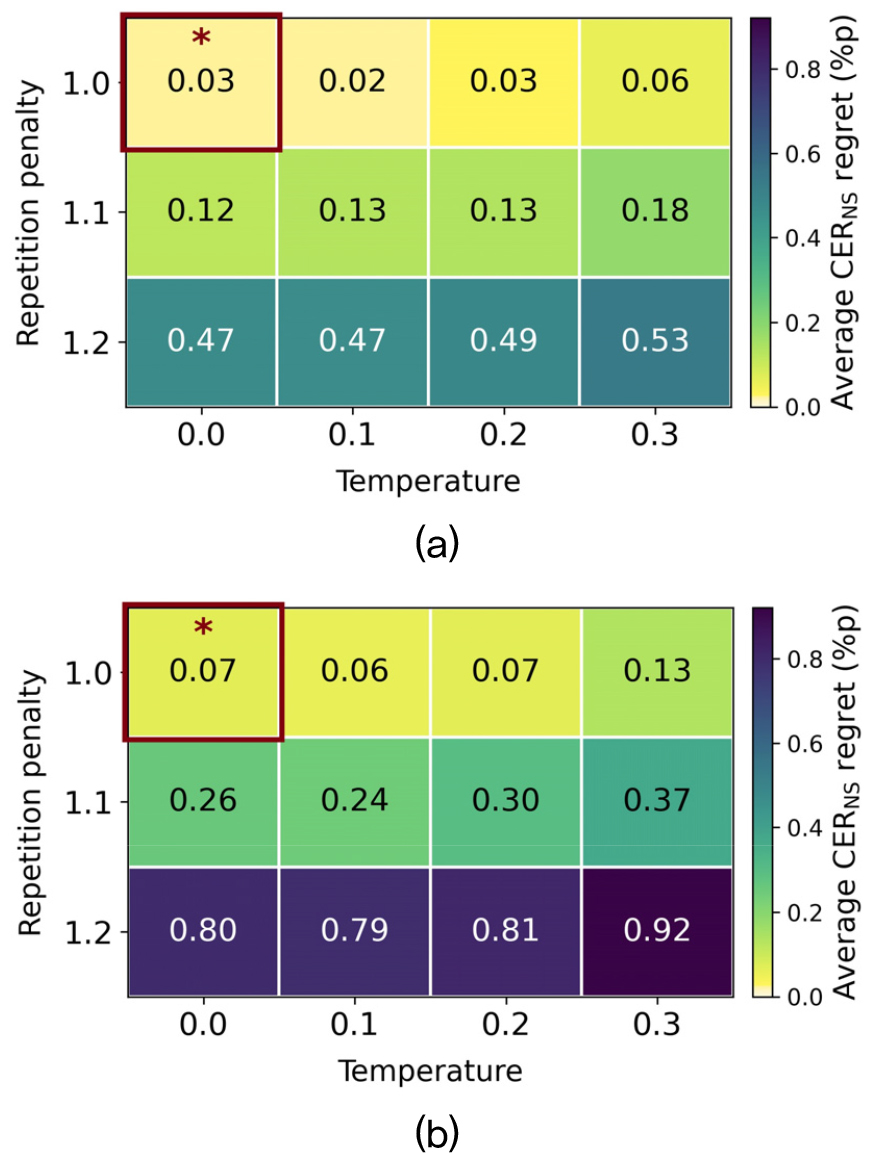
repetition_penalty가 1.0에서 1.1, 1.2로 커질수록 평균 성능 손실도 단계적으로 커졌으며, 증가 폭은 1.7B보다 0.6B에서 더 컸다. 이는 한국어 자동 음성인식 평가에서 반복 억제 강도를 높이는 설정이 안정적인 성능으로 이어지지 않았음을 보여준다.
temperature는 0.2 이하 구간에서는 조건 간 차이가 제한적이었으나 0.3에서는 두 모델 모두 평균 손실이 증가하였다. 일반 텍스트 생성에서는 확률 분포 조정이 출력 다양성을 높이는 수단으로 쓰이지만,[13] 자동 음성인식은 참조 전사와의 일치가 평가 기준이므로 하위 확률 토큰의 선택 가능성이 커질수록 전사 오류로 이어질 수 있으며, 본 실험에서도 높은 temperature 조건에서 이러한 경향이 관측되었다.
대부분의 전사는 512 토큰 이내에 종료되었고 상한을 512 이상으로 늘려도 성능 변화는 제한적이어서, 본 연구의 탐색 범위에서 max_new_tokens는 한국어 인식 성능을 구분하는 주요 요인으로 나타나지 않았다.
추론 설정의 영향은 평가셋 특성에 따라서도 달랐다. 중앙값 대비 최저 CERNS의 개선 폭은 외국인 발화(Foreigner)와 저품질 통화(LowQCall)에서 각각 약 3.8 %p 와 3.7 %p로 컸던 반면, 숫자 중심의 제한된 발화 형식을 가진 NumPattern에서는 약 0.15 %p에 그쳤다. 발음 변이와 채널 품질 차이가 큰 자료일수록 설정 변화의 영향이 커지는 경향으로, 평가셋별 최저값만으로는 여러 자료에 공통으로 적용할 설정을 정하기 어렵다.
5.3 권장 추론 설정 도출 및 검증
개별 최적 조합이 평가셋마다 서로 다르고 코퍼스마다 전체 탐색을 반복하기 어려우므로, 여러 평가셋에서 평균 성능 손실이 작은 설정을 권장 설정으로 도출하였다. Eq. (2)의 평균 성능 손실 이 낮았던 영역(Fig. 2)을 중심으로 language를 korean, max_new_tokens를 512로 고정한 뒤 temperature와 repetition_penalty를 비교하였다. repetition_penalty는 1.0이 다수 평가셋에서 최저값에 가까웠고, temperature는 0.0에서 0.2 구간의 평균 성능 손실 차이가 매우 작아 확률 표집을 쓰지 않는 0.0을 택하였다. 이에 따라 language = korean, max_new_tokens = 512, temperature = 0.0, repetition_penalty = 1.0을 권장 설정으로 도출하였으며, 이는 개별 최적값을 대체하기보다 별도 탐색이 어려운 상황의 기본값으로 제안된다.
도메인·화자 특성이 다른 데이터셋에서는 표본 평가만으로 전체 성능을 판단하기 어려우므로, 전체 발화 결과를 확보한 8개 평가셋에서 권장 설정을 검증하였다. NumPattern과 Welfare는 전체 발화 평가를 수행하지 못해 이 검증에서 제외하였다. Table 4와 같이 표본과 전체의 차이는 대부분 약 1 %p 이내였고, UnivLec·Foreigner에서만 전체 CERNS가 표본보다 증가하였다. 표본 기반으로 도출한 권장 설정이 전체 평가에서도 대체로 유지되었으며, 일부 평가셋에서만 차이가 확인되었다.
Table 4.
CERNS of the recommended setting on the tuning sample and on the full set for each evaluation set.
지금까지의 분석은 서로 다른 녹음 환경과 발화 양식을 포함하는 10개 한국어 평가셋과 Qwen3-ASR의 두 규모를 대상으로 한 것이다. temperature와 반복 억제에서 관측된 방향은 참조 전사와의 일치를 기준으로 삼는 자동 음성인식 시스템의 평가 성질에서 비롯하므로 자기회귀 디코더로 전사를 생성하는 다른 모델에서도 나타날 수 있으나, 본 연구는 이를 확인하지 않았다. 반면 언어 설정은 언어별 값이고 반복 억제의 영향은 한국어의 기능 형태소 반복과 맞물리므로, 다른 언어에는 값을 그대로 옮기기보다 같은 절차로 다시 탐색하는 편이 적절하다.
5.4 Whisper 대비 비교
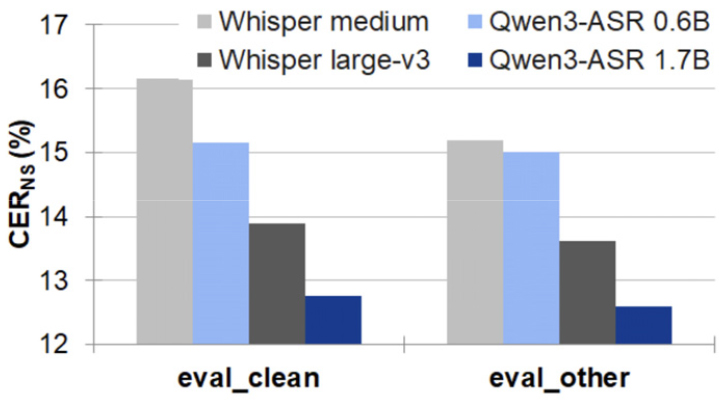
끝으로 Qwen3-ASR의 인식 성능을 기존 공개 모델과 견주어 참고할 수 있도록 Whisper와 비교하였다. 비교는 한국어 음성인식 평가에 널리 쓰이는 KsponSpeech의 eval_clean과 eval_other에서 수행하였다. 두 모델에 동일한 오디오·참조 전사·정규화·지표를 적용하고, 각 모델이 이 두 셋에서 최적 성능을 보인 디코딩 설정으로 비교하였다. Qwen3-ASR은 4.2절의 탐색 범위(Table 2)에서 최적 설정을 선택하였고, Whisper는 temperature 0, length penalty 1.0, early stopping True와 모델별 최대 생성 토큰 수(large-v3 128, medium 96)를 고정한 뒤 beam size를 탐색하여 eval_clean에서 11, eval_other에서 7을 최적값으로 얻었다.
Fig. 3은 그 결과이다. Qwen3-ASR-1.7B는 eval_clean 12.76 %, eval_other 12.60 %를 기록하여 Whisper large-v3의 13.89 %, 13.62 %보다 낮은 오류율을 보였다. Qwen3-ASR-0.6B 역시 eval_clean에서 15.15 % 대 16.16 %, eval_other에서 15.01 % 대 15.19 %로 Whisper medium보다 낮은 오류율을 기록하였다. 이처럼 두 평가셋에 한정된 비교라 한국어 전반의 우위를 단정할 수는 없으나, 이 조건에서는 Qwen3-ASR이 추가 학습 없이 유사 규모의 Whisper보다 다소 낮은 오류율을 보였다.
VI. 결 론
본 연구에서는 대규모 언어모델 디코더 기반 Qwen3-ASR을 대상으로, 10종의 한국어 음성 평가셋에서 0.6B와 1.7B의 추론 파라미터의 영향에 따른 인식 성능을 분석하였다. 한국어 언어 설정과 repetition_penalty 1.0이 다수 평가셋에서 낮은 성능 손실을 보였고, 최대 생성 토큰 수를 512보다 늘려도 뚜렷한 향상은 없었다. 설정 변화의 영향은 평가셋에 따라 달랐으며, 특히 0.6B에서 손실 폭이 더 컸다. 이를 바탕으로 language = korean, max_new_tokens = 512, temperature = 0.0, repetition_penalty = 1.0을 권장 추론 설정으로 도출하였으며, 이 설정은 표본과 전체 평가 모두에서 평가셋별 최저값과 작은 차이를 유지하였다. KsponSpeech에서는 유사 규모의 Whisper보다 낮은 오류율을 보였다.
다만 권장 설정은 본 연구의 코퍼스 풀에서 검증된 것으로, 다른 자동 음성인식 모델과 언어, 새로운 한국어 데이터로의 일반화는 확인되지 않았다. 빔 탐색이나 문맥 정보 주입 등 본 연구가 다루지 않은 설정으로의 확장도 후속 과제로 남는다.