

I. 서 론
II. 실측 자가소음 데이터 구축
2.1 수집 대상 및 장비 구성
2.2 수집 장소·지면 및 동작
2.3 데이터베이스 구성 및 품질 관리
III. 자가소음 특성 분석
3.1 분석 방법 및 지표
3.2 전체 자가소음 특성
3.3 동작 및 수집 조건에 따른 자가소음 특성
IV. 단일채널 실시간 음성 향상 방법
4.1 학습 데이터 구성
4.2 DeepFilterNet3 기반 음성 향상 모델
4.3 손실 함수 및 학습 설정
4.4 실시간 처리 조건
V. 정량 평가 결과
5.1 평가 조건 및 지표
5.2 평가 결과 및 논의
VI. 결 론
I. 서 론
4족보행 로봇은 재난 대응, 산업 점검, 보안 감시와 같은 고위험 환경에서 비정형 지형을 이동하며 원격 조종자에게 현장 정보를 제공할 수 있다.[1] 이러한 환경에서 구조 요청이나 작업자 발화와 같은 음성 단서는 영상 정보만으로 파악하기 어려우며, 음성은 의미 정보를 직접 담고 있어 원격 조종자의 상황 이해와 의사결정에 중요한 역할을 한다. 따라서 우선적으로 로봇 운용 중 수음되는 음성을 명료하게 확보할 필요가 있다.
그러나 4족보행 로봇은 이동 및 자세 제어 과정에서 구동 모터음, 관절 구동음, 발과 지면 접촉 충격음 등 강한 자가소음을 발생시킨다.[2] 이러한 자가소음은 마이크로폰과 동일한 플랫폼에서 발생하고 구조 전달 진동 성분까지 포함할 수 있어 수음된 음성의 명료도와 음질을 저하시킨다. 또한 실제 운용 환경에서는 외부 환경소음도 함께 유입되므로, 자가소음 단독 조건뿐 아니라 두 소음이 공존하는 복합 잡음 조건에서도 목표 음성을 안정적으로 복원하는 기술이 필요하다.
자가소음 처리를 위해 마이크로폰 어레이 기반 공간 필터링, 로봇 내부 센서 정보를 활용한 잡음 예측, 딥러닝 기반 자가소음 억제 방법 등이 연구되어 왔다.[3,4,5,6] 마이크 어레이 기반 방법은 공간 단서를 활용할 수 있으나 장착 안정성, 센서 동기화, 비용, 연산 복잡도에서 제약이 있으며, 로봇 내부 상태 정보를 활용하는 방법은 플랫폼별 센서 접근성과 운용 조건 변화에 따른 재보정이 요구된다. 한편 딥러닝 기반 접근은 드론, 휴머노이드, 이동 로봇 등 일부 플랫폼에서 자가소음 억제 또는 음성 인식 성능 개선을 위해 시도되어 왔으나, 4족보행 로봇의 발과 지면 접촉음과 구동계 소음이 결합된 실측 자가소음 조건을 대상으로 한 연구는 아직 제한적이다.
따라서 본 연구에서는 4족보행 로봇의 실측 자가소음을 반영한 딥러닝 기반 단일채널 실시간 음성 향상 모델의 성능을 검증하고자 한다. 이를 위해 Unitree Go2 로봇에서 실측 자가소음 데이터베이스를 구축하고, 시간에 따른 주파수 특성을 분석한 뒤, 실측 자가소음과 일반 환경소음을 포함한 학습 데이터로 DeepFilterNet3[7,8,9] 기반 단일채널 음성 향상 모델을 학습하였다. 자가소음 학습 모델은 자가소음을 학습하지 않은 환경소음 기준 모델과 비교하여 실측 자가소음 조건에서 평가하였다.
본 연구의 주요 기여는 다음과 같다. 첫째, 10종 수집 장소·지면 조건, 6종 동작 조건, 4개 수음 위치를 고려한 4족보행 로봇 실측 자가소음 데이터베이스를 구축하였다. 둘째, 동작 조건 간 대조와 충격 검출 프레임 기반 스펙트럼 분리를 통해, 모터 회전수의 동기 계측 없이 자가소음을 내부 구동계에 기인하는 협대역 성분과 발과 지면 접촉에 기인하는 충격 성분으로 분리하고 각각의 주파수·시간 특성을 정량화하였다. 셋째, 실측 자가소음 조건에서 평가하여, 환경소음만 학습한 기준 모델 대비 음성 명료도 평가(Short Time Objective Intelligibility, STOI),[10] 객관적 음질 평가(Perceptual Evaluation of Speech Quality, PESQ),[11] 기준 음성 대비 복원 신호의 왜곡 정도(Scale Invariant Signal to Distortion Ratio, SI-SDR)[12]를 향상시킴을 확인하였다.
본 논문은 2장에서 실측 자가소음 데이터베이스 구축 과정을, 3장에서 자가소음의 시간에 따른 주파수 특성을, 4장에서 단일채널 실시간 음성 향상 방법을, 5장에서 정량 평가 결과를 기술하고, 6장에서 결론과 향후 연구 방향을 논의한다.
II. 실측 자가소음 데이터 구축
2.1 수집 대상 및 장비 구성
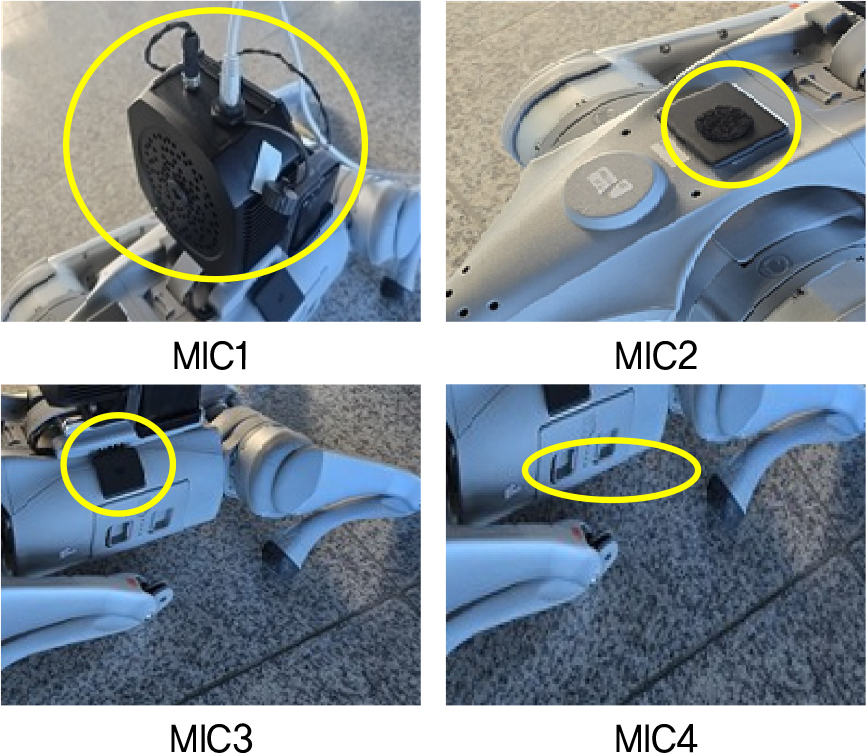
4족보행 로봇의 자가소음은 구동 모터, 감속기, 관절부, 발과 지면 접촉부 등 여러 위치에서 발생하며, 마이크로폰의 장착 위치에 따라 수음되는 음향 특성이 달라질 수 있다. 이에 Fig. 1과 같이, Unitree Go2 로봇 본체의 등 상단, 전방 상단, 좌측 측면, 하부의 4개 지점에 음향 수집 장비를 배치하였다. 즉, 등 상단에는 음향 카메라(SoundCam Acoustic Camera)를 MIC1로,[13] 전방 상단과 좌측 측면에는 휴대형 녹음기(IZYREC R1)를 각각 MIC2와 MIC3으로,[14] 하부에는 스마트폰(Galaxy S24 Ultra)을 MIC4로 배치하였다.[15] 수집 장비별 원시 녹음 사양과 공개된 주파수 응답 정보가 서로 다르므로, 모든 음원은 후처리 과정에서 리샘플링과 모노 다운믹스를 거쳐 48 kHz, 16 bit, mono WAV 형식으로 통일하였다.
2.2 수집 장소·지면 및 동작
수집 장소·지면 조건은 실내 5종과 실외 5종, 총 10종으로 구성하였다. 실내는 잔향 특성이 서로 다른 공간으로 구성하고 크기가 다른 두 복도를 포함하였으며, 실외는 지면 재질을 달리하여 발과 지면 접촉음의 차이가 반영되도록 하였다. 수집 환경과 환경별 샘플 수는 Table 1에 정리하였다.
Table 1.
Ego noise collection environments.
로봇 동작 조건은 이동, 정지, 자세 전환, 회전 등 운용 상태에 따른 자가소음 변화를 포함하도록 총 6종으로 설정하였다. Walking과 Running은 보행 속도가 다른 이동 상태, Turning은 제자리 방향 전환 상태이며, Idle은 보행 없이 대기하여 내부 구동계 소음만을 수집한 조건이다. 각 동작 조건의 코드, 샘플 수, 주요 소음 특성은 Table 2에 정리하였다.
Table 2.
Ego noise collection motion conditions.
2.3 데이터베이스 구성 및 품질 관리
각 음원 파일에는 MIC[ID]_Movement[ID]_PLACE [ID].wav 형식의 파일명 규칙을 적용하고, 녹음 장비 등의 메타데이터를 함께 기록하였다. 품질 검수에서는 모든 파일에 대해 클리핑, 60 Hz 험 노이즈, 전기적 간섭, 장비 간 레벨 편차를 점검하였으며, 바람·차량·인적 활동에 의한 비의도적 생활소음 유입을 검토하여 기준에 부합하지 않는 구간은 제외하거나 재녹음하였다. 최종 데이터베이스는 총 170개 샘플, 53 min 39 s 분량으로 확정되었으며, 주요 사양은 Table 3에 요약하였다.
Table 3.
Summary of the ego noise database.
데이터 분할은 2단계로 수행하였다. 먼저 파일 단위 무작위 분할로 학습용 80 %와 평가용 20 %를 구성하였고, 학습용을 다시 학습 세트와 검증 세트로 분할하였다. 원본 발화 수 기준 학습 세트와 검증 세트의 비율은 85.2 대 14.8이다. 세 세트는 각각 독립된 데이터셋으로 구축하였으며, 동일한 환경 및 수집 세션의 데이터가 두 세트 이상에 중복 포함되지 않도록 구성하고, 마이크별 데이터 비율이 편중되지 않도록 분할하였다.
III. 자가소음 특성 분석
3.1 분석 방법 및 지표
시간에 따른 주파수 분석은 48 kHz 자가소음 신호에 단시간 푸리에 변환을 적용하여 수행하였다. 단시간 푸리에 변환에는 Hann window를 사용하였고, 고속 푸리에 변환 크기와 hop 크기는 각각 2,048 샘플 및 512 샘플, 분석 대역은 100 Hz ~ 8,000 Hz로 설정하였다. 자가소음의 스펙트럼 구조를 분석하기 위해 스펙트럼 평탄도와 협대역 피크 수를 사용하였다. 스펙트럼 평탄도는 파워 스펙트럼의 기하평균과 산술평균의 비로 산출하였으며, 0에 가까울수록 순음에, 1에 가까울수록 백색소음에 가까운 구조를 의미한다. 협대역 피크 수는 시간 평균 파워 스펙트럼에 피크 검출(scipy.signal.find_peaks)을 적용하여 검출된 국소 피크의 개수로 정의하였다. 또한 발과 지면 접촉음과 같은 시간적 충격 성분을 분석하기 위해 Onset strength의 국소 최댓값으로 검출된 음향 이벤트 수를 신호 길이로 나눈 Onset rate(회/s)와, 높은 Onset strength를 갖는 프레임의 비율로 정의되는 Impulsiveness를 사용하였다. Onset rate는 이벤트의 발생 빈도를, Impulsiveness는 이벤트의 세기를 나타낸다.
3.2 전체 자가소음 특성
Fig. 2는 대표 동작 조건에서 수집된 자가소음의 파형과 스펙트로그램을 나타내며, (b) Walking과 (c) Running 조건에서는 발과 지면 접촉에 따른 충격 성분이 시간축을 따라 반복적으로 나타난다. 각 성분의 주파수 분포를 확인하기 위해, Fig. 2와 동일한 0 s ~ 4 s 구간에 대해 앞서 기술한 단시간 푸리에 변환 설정으로 평균 파워 스펙트럼을 산출하여 Fig. 3에 제시하였다. 각 프레임의 파워 스펙트럼은 선형 영역에서 평균한 뒤 dB 단위로 나타냈으며, Walking과 Running에서는 Onset이 검출된 프레임과 그 전후를 충격 프레임으로, 나머지를 비충격 프레임으로 구분하여 각각 산출하였다. 충격 프레임의 폭은 Walking에 전후 2프레임, Running에 전후 1프레임을 적용하였고, 그 비율은 각각 89/372 프레임(23.92 %)과 157/372 프레임(42.20 %)이다. Running에 전후 2프레임을 적용하면 충격 프레임이 61.56 %에 달해 비충격 프레임이 충격 직후의 감쇠 구간을 포함하게 되므로 폭을 줄였다. 협대역 피크는 Idle의 전체 프레임 평균 스펙트럼에서 검출하고, Walking과 Running의 비충격 프레임 평균 스펙트럼에서 주파수 차이 ±100 Hz 이내의 대응 피크를 확인하였다.
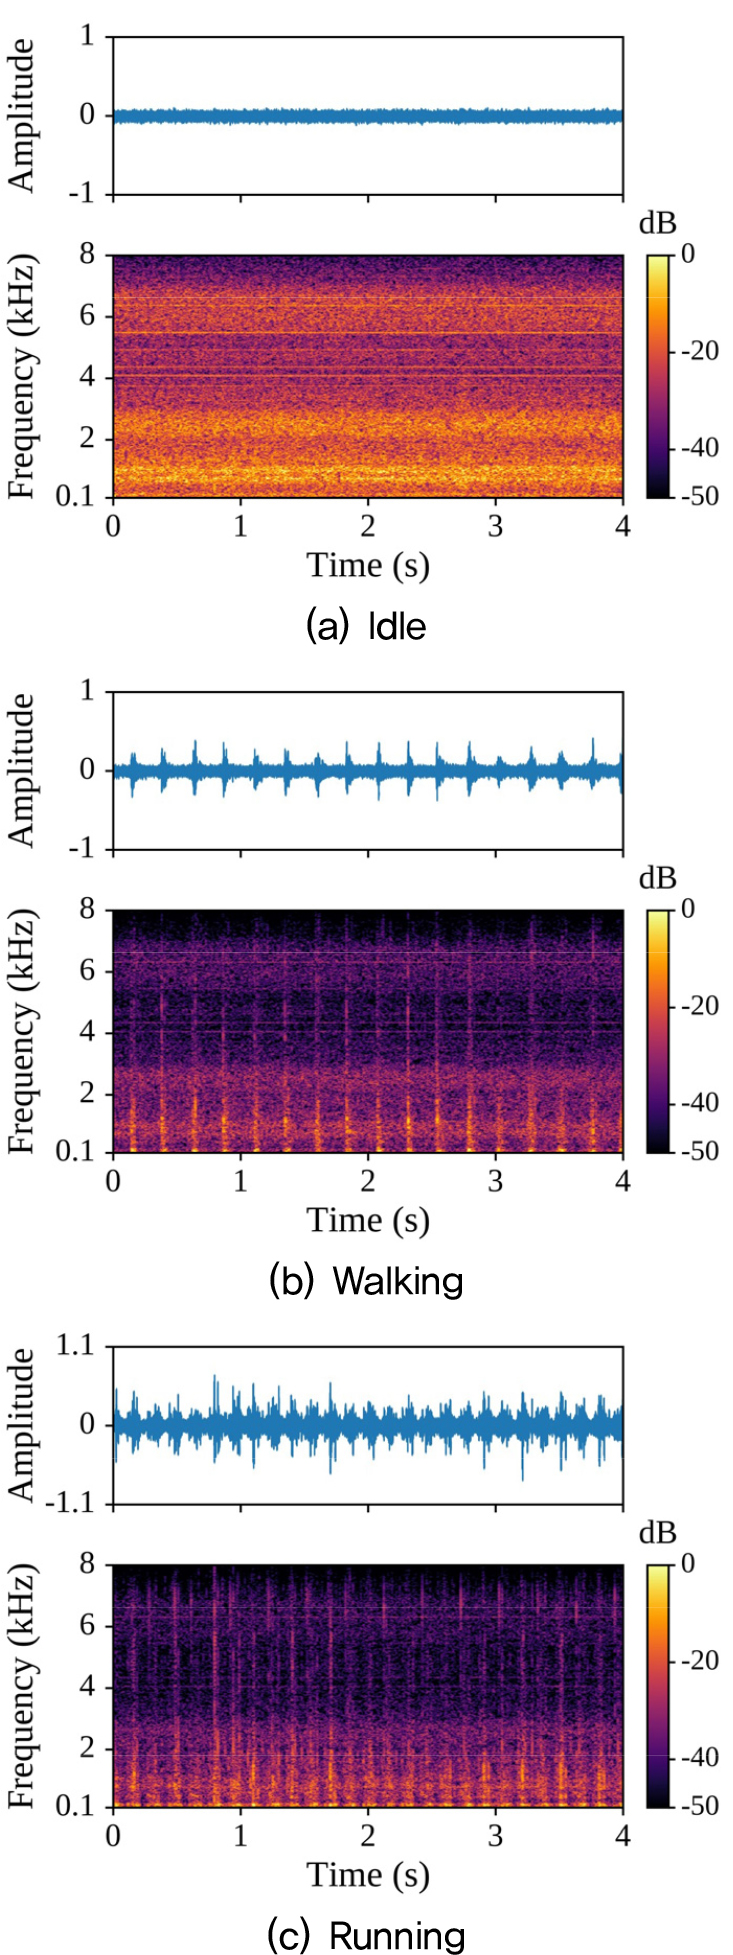
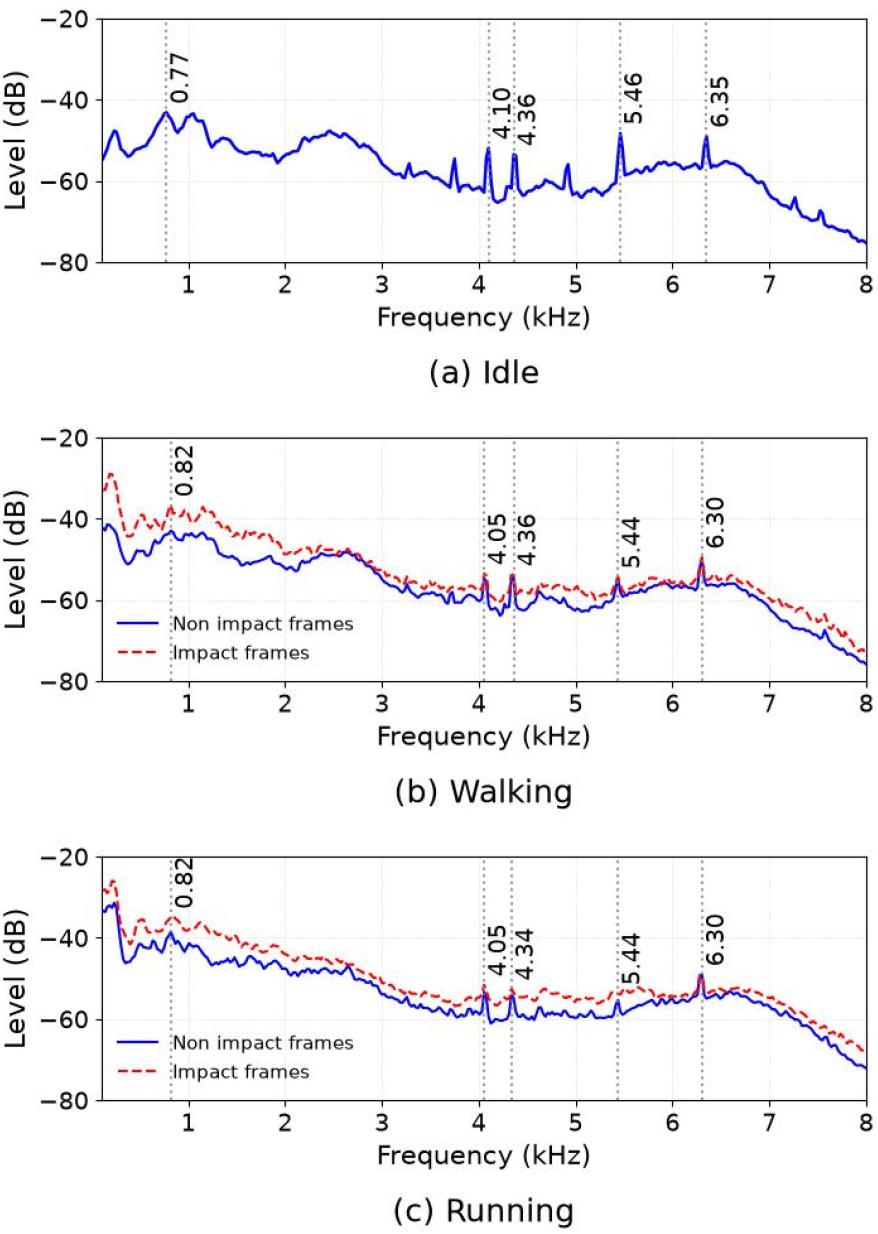
Fig. 3에서 보행이 없는 Idle 조건은 약 (0.77, 4.10, 4.36, 5.46, 6.35) kHz 부근에 협대역 피크를 보였으며, 각 피크는 주변 배경 대비 평균 약 8.7 dB(범위 4.1 dB ~ 11.2 dB) 높게 나타났다. 이에 대응하는 피크가 Walking과 Running의 비충격 프레임에서도 최대 47 Hz 차이의 근접한 위치에 관찰되었으며, 협대역 성분은 보행 여부와 무관하게 존재하므로 내부 구동계에서 발생하는 것으로 판단된다. 반면 충격 프레임에서는 협대역 피크의 위치가 유지된 채 분석 대역 전반에서 배경 성분의 레벨이 상승하였으며, 비충격 프레임 대비 100 Hz ~ 1 kHz, 1 kHz ~ 4 kHz 및 4 kHz ~ 8 kHz 대역에서 Walking은 각각 8.85 dB, 4.56 dB 및 1.90 dB, Running은 각각 4.39 dB, 4.10 dB 및 2.19 dB 높았다. 즉 충격 성분은 분석 대역 전반에 에너지를 더하되 상승 폭은 저역에서 크고 고역으로 갈수록 작아지며, 협대역 성분의 위치에는 영향을 주지 않는다.
협대역 피크들 사이에서는 뚜렷한 배음 관계가 확인되지 않았으며, 특히 4.10 kHz와 4.36 kHz는 서로 근접한 위치에 함께 나타났다. Unitree Go2는 각 다리에 복수의 관절 구동 모터를 사용하므로, 관측된 피크는 단일 회전체의 고조파열이 아니라 회전 속도가 서로 다른 복수 구동원의 성분이 중첩된 것으로 보인다. 다만 본 연구에서는 모터 회전수와 관절 제어 신호를 음향 신호와 동기화하여 측정하지 않았으므로, 개별 피크를 특정 모터나 고조파 차수에 대응시키지는 않았다.
이러한 구조는 전체 통계로도 확인된다. 170개 샘플에서 자가소음은 평균 11.2개의 협대역 피크를 보였고, 스펙트럼 평탄도는 평균 0.041로 에너지가 평탄하게 분포하지 않고 특정 주파수에 집중되어 있음을 나타냈다. 또한 Onset rate는 평균 6.8회/s로, 지속성 기계음 외에 동작 과정의 반복적 음향 이벤트가 함께 존재함을 보여준다.
이상을 종합하면, 4족보행 로봇의 자가소음은 단일 순음이나 평탄한 배경소음으로 설명하기 어렵고, 내부 구동계에 기인한 협대역 성분과 발과 지면의 접촉에 기인한 충격 성분이 함께 존재하는 구조를 가진다.
3.3 동작 및 수집 조건에 따른 자가소음 특성
로봇의 동작 조건에 따른 자가소음 특성을 협대역 피크 수, Onset rate 및 Impulsiveness를 기반으로 정량적으로 비교하였다. Table 4에서 보듯 동작 조건에 따라 특성이 뚜렷이 갈렸다. Idle 조건은 협대역 피크 수가 22.8로 가장 높아 보행이나 자세 변화가 없어도 센서·모터 등 내부 구동계의 지속성 기계음이 존재함을 보여준다. 반면 Running은 협대역 피크 수가 6.2로 가장 적고 Onset rate가 12.5로 가장 높게 나타났다. Running의 Onset rate가 Walking보다 높은 것은 보행 주기가 빨라져 발과 지면 접촉 횟수가 증가한 결과이며, 두 조건의 Impulsiveness는 0.054와 0.055로 유사하다. 한편 발과 지면 접촉이 없는 Idle에서도 Onset rate가 11.8회/s로 높게 나타났는데, 이는 내부 구동계의 주기적 진동이 음향 이벤트로 검출된 결과이며, Impulsiveness가 0.024로 가장 낮아 개별 이벤트의 세기는 약하였다. 즉 Onset rate는 이벤트의 빈도를, Impulsiveness는 그 세기를 반영하므로, 두 지표를 함께 보면 보행 계열(Walking 0.054, Running 0.055)의 강한 충격 성분과 정지·대기 계열(Idle 0.024, Sit and stand 0.025)의 약한 주기적 이벤트가 구분된다.
Table 4.
Key ego noise indicators by motion condition.
| Movement | NPC | Onset rate (events/s) | Impulsiveness |
| Walking | 9.0 | 6.1 | 0.054 |
| Running | 6.2 | 12.5 | 0.055 |
| In place walking | 11.5 | 5.1 | 0.060 |
| Sit and stand | 16.2 | 2.5 | 0.025 |
| Idle | 22.8 | 11.8 | 0.024 |
| Turning | 13.0 | 4.7 | 0.059 |
수집 환경에 따라서도 특성이 달라져, 실내에서는 벽면과 천장에 의한 반사 및 공진의 영향으로 협대역 피크가 상대적으로 많이 관찰되었고(평균 협대역 피크 수 약 12 ~ 13, 실외 약 7 ~ 11), 실외에서는 지면 재질에 따른 발과 지면 접촉음의 차이가 두드러졌다. 아스팔트, 보도블록, 철판과 같은 단단한 표면에서는 접촉 충격음이 명확하게 나타났고, 자갈에서는 불규칙한 접촉으로 신호 진폭의 제곱평균제곱근(Root Mean Square, RMS)이 0.094로 가장 크게 나타났다.
IV. 단일채널 실시간 음성 향상 방법
4.1 학습 데이터 구성
학습에 사용한 음성은 한국어 감정 음성(KrEmotion[16]), 한국어 자연발화(KsponSpeech[17]), 영어 음성(Valentini[18]), 다국어 음성(DNS Challenge[19])으로 구성하였다. 잡음은 다국어 음성과 영어 음성의 일반 환경소음, 본 연구에서 수집한 실측 자가소음을 사용하였다.
학습 입력은 사전에 고정된 데이터셋으로 만들지 않고, 학습 중 매 배치마다 깨끗한 목표 음성에 잡음을 혼합하는 on the fly 증강 방식을 사용하였다. 자가소음은 지면·동작·수음 위치에 따라 특성이 크게 달라지므로, 매 혼합마다 목표 음성과 잡음 소스를 무작위로 선택하였다. 잡음은 일반 환경소음과 실측 자가소음 중 하나만 사용하거나 두 종류를 함께 사용하며, 각 잡음에 입력 게인을 {–6, 0, 6} dB에서 독립적으로 샘플링하여 적용한 뒤 시간 영역에서 합산하였다. 신호대잡음비(Signal to Noise Ratio, SNR)는 목표 음성과 합산된 전체 잡음 사이의 비로 정의하고 {–10, –7, –5, 0, 3, 5, 7, 10, 15, 20, 40} dB에서 샘플링하였으며, 두 잡음 사이의 상대 에너지 비는 별도로 설정하지 않았다. 잔향은 확률 0.1로 다국어 음성 제공 공간 임펄스 응답(Room Impulse Response, RIR)을 적용하였으며, 이때 목표 음성과 합산된 잡음에 동일한 RIR을 사용하였다. 손실 계산의 참조 신호로는 동일 RIR을 적용한 음성에서 후기 잔향을 억제한 신호를 사용하였다. 실측 자가소음은 일반 환경소음보다 높은 비율로 반복 샘플링하여, 매 에폭에서 충분한 빈도로 학습에 포함되도록 하였다. 환경소음 기준 모델과 자가소음 학습 모델은 음성 데이터와 학습 설정을 동일하게 두고, 학습 잡음에 실측 자가소음의 포함 여부만 달리하였다.
4.2 DeepFilterNet3 기반 음성 향상 모델
3장에서 확인한 바와 같이 4족보행 로봇의 자가소음은 내부 구동계에 기인하는 협대역 성분과 발과 지면 접촉에 기인하는 충격 성분이 결합된 구조를 가진다. 진폭 성분만 보정하는 방식에서는 위상 불일치로 인한 음질 왜곡이 발생할 수 있으므로,[20] 크기 스펙트럼뿐 아니라 복소 스펙트럼 성분을 함께 고려하는 모델이 요구된다고 판단하였다. 또한 로봇 온보드 환경에 적용하기 위해서는 48 kHz 전대역 입력을 단일채널 스트리밍 방식으로 처리하면서 낮은 지연시간과 연산 복잡도를 유지할 수 있어야 한다. 이에 본 연구에서는 두 조건을 함께 만족하는 DeepFilterNet3를 사용하였다.[7,8,9]
DeepFilterNet3는 2단계 구조로, 첫 번째 단계에서는 인간 청각 특성을 반영한 등가사각대역폭(Equivalent Rectangular Bandwidth, ERB) 스케일에서 대역별 이득을 추정하여 잡음 성분을 억제하고, 두 번째 단계에서는 복소 스펙트럼 영역에서 Deep filtering을 적용하여 목표 음성 성분을 복원한다. 신호 처리 설정은 DeepFilterNet3의 기본값을 따랐으며, 48 kHz 입력에 대해 ERB 32개 대역, Deep filtering 적용 대역 약 5 kHz(96개 주파수 빈), 필터 차수 5를 사용하였다.[8]
3장의 지표는 두 성분이 ERB 대역별 이득 추정에 어떤 조건을 요구하는지 보여준다. Idle의 협대역 피크 수가 22.8로 가장 높다는 것은 협대역 성분이 여러 대역에 흩어져 있음을 뜻하며, 이 성분은 음성의 고조파와 마찬가지로 좁은 구간에 지속적으로 존재하므로 대역 단위의 이득만으로 둘을 구분하기 어렵다. Running의 Onset rate 12.5회/s는 약 80 ms마다 그보다 짧은 충격이 발생함을 의미하며, 여러 대역의 이득이 이 간격으로 반복해서 오르내려야 한다. 대역별 이득은 학습을 통해 추정되므로, 본 연구에서는 이러한 조건을 학습 데이터에 반영하기 위해 실측 자가소음을 포함하였다.
기준 모델과 자가소음 학습 모델은 모두 사전학습 가중치를 사용하지 않고 무작위 초기화 상태에서 처음부터 학습하였다.
4.3 손실 함수 및 학습 설정
모델 학습에는 고속 푸리에 변환 크기 {256, 512, 1024, 2048}에서 크기 및 복소 스펙트럼의 일치도를 평가하는 다중 해상도 스펙트럼 손실()과 지역적 SNR 추정 손실()을 사용하였다. 전체 손실은 Eq. (1)과 같이 구성되며, 두 손실의 가중치(𝜆mr, 𝜆snr)는 DeepFilterNet3의 기본 설정을 따랐다.[7,8,9]
학습에는 AdamW optimizer를 사용하였으며, Learning rate는 3 에폭의 warmup 후 1×10⁻³에서 1×10⁻⁶까지 cosine 방식으로 감소시켰다.[7,8,9] Batch size는 16에서 시작하여 에폭 진행에 따라 최대 128까지 증가시키는 스케줄링을 적용하였다.[7,8,9] 학습 에폭 수는 최대 500으로 설정하고, 검증 세트의 손실이 50 에폭 동안 개선되지 않으면 학습을 종료하였다. 최종 모델은 검증 손실이 가장 낮은 시점의 체크포인트를 선택하였다.
4.4 실시간 처리 조건
본 연구에서 사용한 모델은 48 kHz에서 프레임 크기 960 샘플(20 ms), hop 크기 480 샘플(10 ms), lookahead 2 프레임으로 설정하였으며, 최소 알고리즘 지연시간은 20 ms + 2 × 10 ms = 40 ms로 산출된다. 다만 이 값은 모델 구조와 스트리밍 파라미터에 따른 것이며, 실제 시스템 적용 시에는 오디오 입출력 버퍼링, 장치 드라이버, 운영체제 스케줄링에 따른 추가 지연이 발생할 수 있다. DeepFilterNet3는 노트북급 CPU 및 임베디드 장치에서 실시간 처리(real time factor < 1)가 보고된 경량 구조이며,[7,8] 로봇 온보드 컴퓨터에서의 실제 추론 시간 측정은 향후 연구로 남긴다.
V. 정량 평가 결과
5.1 평가 조건 및 지표
평가는 영어와 한국어 조건에서 각각 수행하였으며, 비교 조건은 미처리 입력, 환경소음 기준 모델, 자가소음 학습 모델의 세 가지로 설정하였다. 미처리 입력은 혼합 신호에 음성 향상 처리를 적용하지 않은 조건이며, 두 모델의 학습 조건 차이는 학습 잡음의 실측 자가소음 포함 여부뿐이다(4.1절).
학습과 달리 평가에는 사전에 고정한 테스트 세트를 사용하였으며, 모든 비교 모델을 동일한 신호로 평가하였다. 평가용 음성은 영어의 경우 Valentini의 공식 test 분할(824발화), 한국어의 경우 AI Hub에서 제공하는 KrEmotion 평가용 데이터베이스(1,000발화)를 사용하였다. 두 모델의 차이가 자가소음 학습 여부에서만 비롯되도록, 평가용 혼합 신호는 깨끗한 목표 음성에 Unitree Go2 실측 자가소음만을 혼합하여 2.5 dB ~ 17.5 dB 범위의 SNR 조건에서 미리 생성하였다. 지표는 혼합에 사용한 깨끗한 목표 음성을 참조 신호로 하여 산출하였다.
평가 지표로는 음성 명료도, 지각 음질 및 목표 음성 대비 신호 복원 정도를 사용하였으며, 세 지표 모두 값이 클수록 성능이 우수함을 의미한다. 모든 처리는 48 kHz에서 수행하고, 지표 계산 시에는 향상 출력과 참조 음성을 16 kHz로 리샘플링하였다.
5.2 평가 결과 및 논의
Table 5는 세 비교 조건의 음성 향상 성능을 영어와 한국어 조건별로 정리한 것이다. 평가에 사용한 테스트 샘플의 SNR이 서로 다르므로, 개선 폭을 직접 비교할 수 있도록 미처리 입력 대비 향상값을 함께 제시하였다. 평균 향상값은 환경소음 기준 모델과 자가소음 학습 모델에서 각각 STOI 0.08과 0.11, PESQ 0.98과 1.44, SI-SDR 5.39와 8.00 dB로 나타났으며, 특히 한국어 조건의 PESQ 향상값은 0.75와 1.42로 약 두 배의 차이를 보였다. 두 모델이 동일한 실측 자가소음 조건에서 평가되었다는 점에서, 이 격차는 일반 환경소음만으로 학습한 음성 향상 모델이 4족보행 로봇 자가소음에 대해 확보하지 못하는 성능의 크기를 나타낸다.
Table 5.
Speech enhancement performance under ego noise conditions.
언어별로 보면 자가소음 학습 모델은 환경소음 기준 모델 대비 영어 조건에서 STOI 0.91 → 0.92, PESQ 2.51 → 2.74, SI-SDR 16.68 → 17.82 dB, 한국어 조건에서 STOI 0.83 → 0.88, PESQ 2.12 → 2.79, SI-SDR 14.00 → 18.07 dB로, 두 언어에서 모두 세 지표가 함께 개선되었다. 두 모델은 동일한 음성 데이터로 학습되었고 학습 잡음 구성만 달랐으므로, 이러한 향상은 실측 자가소음을 학습에 포함한 데 따른 것으로 볼 수 있다. 다만 평균 PESQ는 2.77로, 지각 음질 측면에서는 추가 개선의 여지가 있다.
VI. 결 론
본 연구에서는 4족보행 로봇의 실측 자가소음 조건에서 단일채널 실시간 음성 향상 방법의 적용 가능성을 검증하였다. 이를 위해 Unitree Go2 로봇의 자가소음 데이터베이스를 구축하고, 자가소음의 시간에 따른 주파수 특성을 분석한 뒤, 실측 자가소음을 DeepFilterNet3 기반 음성 향상 모델 학습에 반영하였다.
먼저, 시간에 따른 주파수 특성 분석 결과, 4족보행 로봇의 자가소음은 단일 순음이나 평탄한 잡음이 아니라, 내부 구동계에 기인하는 협대역 성분과 발과 지면 접촉에 기인하는 충격 성분이 동작 조건에 따라 서로 다른 비율로 결합된 구조를 보였다. DeepFilterNet3의 두 단계와 각각 관련되어, 협대역 성분은 ERB 대역별 이득 추정의 대상이 되고 대역 이득만으로 분리되지 않는 성분은 복소 스펙트럼 Deep filtering이 다룬다. 이때 두 성분이 함께 존재하는 조건에서 적절한 이득을 추정하려면 해당 잡음이 학습에 포함되어야 한다. 자가소음 학습 모델은 자가소음 조건에서 환경소음 기준 모델 대비 영어와 한국어 모두에서 평균 STOI 0.87 → 0.90, PESQ 2.31 → 2.77, SI-SDR 15.34 → 17.95 dB로 향상되었으며, 구조와 학습 설정이 같고 학습 잡음의 구성만 달랐다는 점에서 이는 실측 자가소음을 학습에 포함한 결과로 볼 수 있다. 알고리즘 지연시간은 40 ms로 산출되었다. 다만 평균 PESQ는 2.77로, 지각 음질 측면에서는 개선의 여지가 있다.
향후 연구에서는 다양한 로봇 플랫폼과 운용 환경으로 데이터를 확장하고, 미학습 조건에 대한 일반화 성능을 검증하며, 데이터 분량이 적은 조건을 보강할 필요가 있다. 이와 함께 동작 조건과 지면 재질별로 평가 세트를 구성하여 조건별 강인성을 정량적으로 평가하는 작업이 요구된다. 아울러 저 SNR 조건과 지각 음질 개선을 위한 학습 전략, 그리고 온보드 환경에서의 실시간 구현 검증이 필요하다. 온보드 환경의 연산 제약을 고려하여 모델 구조를 조정하려면, ERB 대역별 이득 추정과 복소 스펙트럼 Deep filtering이 자가소음 억제에 기여하는 정도를 분리하여 확인해야 한다. 끝으로 자가소음은 로봇 본체의 마이크로폰으로 수집되어 발생원과의 거리가 짧고 직접음이 우세하므로, 원거리 음원을 가정한 잔향 증강이 이에 부합하는지 검토하고 별도의 잔향 조건을 적용하는 방안을 살펴볼 필요가 있다.